一、软件简介
CUDA Toolkit 是 NVIDIA 官方推出的GPU 通用并行计算完整开发套件,基于 CUDA SIMT 并行编程模型,用来开发、编译、调试、部署 GPU 加速程序,打通 CPU 与 NVIDIA GPU 异构计算链路NVIDIA。
- 授权与定位:免费商用开发套件,闭源内核工具链,配套开源计算库;覆盖桌面工作站、服务器、云算力、Jetson 嵌入式设备、超算 HPC 全场景NVIDIA 开发者。
- 核心组成
- NVCC CUDA C/C++ 编译器、PTX 中间指令集编译链
- CUDA Runtime / 驱动 API 运行时库、多 GPU 通信库 NCCL
- 全套 GPU 加速数学、AI、信号处理预制库
- Nsight 调试、性能剖析、内存检测全套工具链
- Python 绑定、示例工程、完整开发文档与编译脚本
- 应用领域:大模型 AI 训练推理、科学仿真、分子动力学、图像视频渲染、密码运算、金融量化、数字孪生、嵌入式边缘 AI;PyTorch、TensorFlow、TensorRT 底层均依赖 CUDA Toolkit 编译运行NVIDIA 开发者。
- 架构兼容:统一一套工具包同时适配 x86_64 服务器、ARM64 数据中心、Jetson 嵌入式 ARM 平台,一次编译多端部署NVIDIA。
二、主要功能
1. 编译与语言开发体系
- NVCC 编译器:混合编译 CUDA C/C++ 代码,分离 CPU 主机代码与 GPU 设备内核代码,输出可执行程序、PTX 中间码、设备二进制 fatbin 文件;支持 C++17/C++23 新标准、CUDA 自定义内核语法、Tile 块编程语法NVIDIA。
- 多语言支持:原生 C/C++;配套 CUDA Python、cuTile Python、Numba;兼容 Fortran、DPC++ 异构编译扩展。
- 跨架构编译:单次编译包兼容多款 GPU 架构(Ampere/Ada/Hopper/Blackwell),无需分硬件打包。
2. 高性能加速函数库(开箱即用,无需手写内核)
- 基础数学线性代数
- cuBLAS:矩阵乘、向量运算,AI 大模型 GEMM 核心依赖
- cuSPARSE:稀疏矩阵加速,推荐系统、有限元仿真
- cuSOLVER:矩阵分解、特征值求解、方程组求解
- 信号与变换
- cuFFT:高速傅里叶变换,图像、雷达、声学仿真
- cuRAND:GPU 高速随机数生成,蒙特卡洛模拟、AI 采样
- AI 专用库
- CUTLASS:自定义张量内核模板库,Transformer、MoE 模型优化
- NCCL:多 GPU 高速集合通信,分布式训练多卡同步
- 通用工具库
- Thrust/CUB/CCCL:GPU 标准算法容器、并行排序、规约、扫描;替代 CPU STL 并行逻辑NVIDIA。
3. 调试、剖析与优化工具(Nsight 全家桶)
- Nsight Compute:单 GPU 内核深度剖析,寄存器占用、张量核心利用率、共享内存瓶颈、指令延迟可视化,定位内核性能短板NVIDIA。
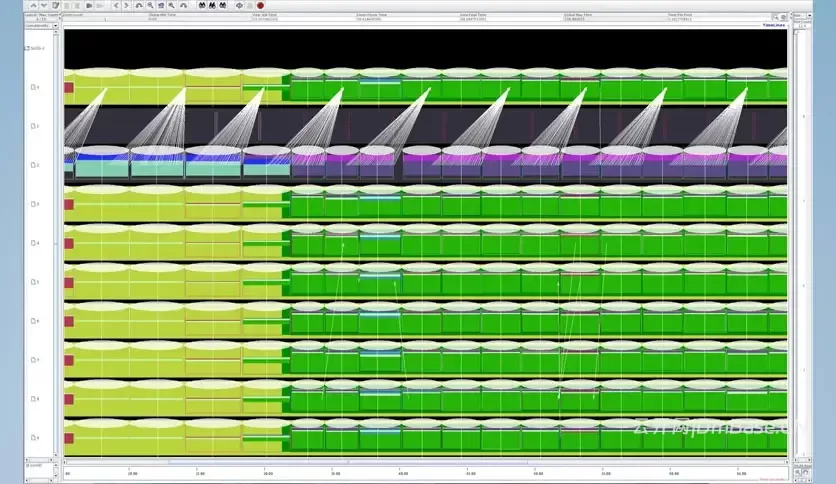
- Nsight Systems:全栈时序分析,CPU-GPU 调度、流依赖、内存拷贝、多进程多 GPU 全局时序图谱。
- cuda-gdb:GPU 内核断点调试,查看设备线程、寄存器、显存变量。
- Nsight Copilot:AI 辅助 CUDA 代码优化、报错诊断、内核改写建议。
- 内存检测工具:检测显存越界、空指针、同步锁死、内存泄漏。
4. 内存、多卡与任务调度能力
- 统一内存(Unified Memory):CPU/GPU 显存透明寻址,自动分页迁移,简化异构内存管理。
- 异步流(Stream)、任务图(Graph):批量封装 GPU 任务,降低 CPU 调度开销,大推理场景大幅降延迟。
- 多 GPU 拓扑管理:NCCL 多卡互联、NVSwitch 高速互联、跨节点分布式通信接口。
- 内存池、属性异步拷贝、上下文隔离、进程检查点快照,适配云容器多租户场景NVIDIA。
5. Python 生态与部署能力
- CUDA Python 1.0 稳定版:完整 Runtime API Python 绑定,支持绿色上下文、进程快照、低延迟调度NVIDIA。
- cuTile Python:高层 Tile 块编程,自动调度共享内存、张量流水线,大幅降低高性能内核编写难度NVIDIA 开发者。
- 支持容器打包、WSL2 Windows 子系统、Jetson 嵌入式交叉编译、云端镜像一键部署。
三、更新内容(CUDA Toolkit 13.3 2026 年 5 月稳定版)
(一)编程模型重大升级:CUDA Tile C++ 正式稳定
- Tile 编程全面落地 C++ 体系,和原生 CUDA C++ 无缝混用,自动管理共享内存、张量分块、流水线调度,无需手动调度线程块层级逻辑NVIDIA。
- 兼容 Hopper (9.0)、Ampere (8.x)、Ada、Blackwell 全系列新架构;cuTile Python 新增闭包、递归、自定义规约、高级数组切片语法NVIDIA。
- 原生支持 4bit/FP8/MXFP8 低精度张量,适配大模型轻量化推理与训练。
(二)编译器革新
- NVCC 完整官方支持C++23标准,CCCL 计算库升级至 3.3,完善 DLPack、mdspan 张量互操作规范NVIDIA。
- CompileIQ 自动调优框架:自动遍历编译参数优化 GEMM、Attention 等核心内核,最高提速 15%NVIDIA。
- fatbin 默认改用 ZStd 压缩,减小程序包体积、加快加载速度;PTX ISA 9.2 指令集全面适配 Blackwell 架构新硬件指令。
(三)数学与 AI 库性能增强
- cuBLAS 新增 Blackwell 专属分组 GEMM(Grouped GEMM)MXFP8 加速,MoE 混合专家模型训练速度显著提升NVIDIA。
- cuSOLVER 提供 FP64 仿真加速 API,在 INT8 算力平台上提升 LU、QR、乔列斯基分解性能。
- CUTLASS 针对 Blackwell 第二代 Transformer 引擎深度优化 LLM 内核。
(四)Nsight 工具链更新
- Nsight Compute 新增寄存器依赖可视化、报告聚类对比、Tile 内核专属分析视图。
- Nsight Python 支持 Numba-CUDA 内核调试,Python GPU 代码可断点、逐行剖析。
- Nsight Systems 优化多节点分布式训练时序渲染,支持万卡集群追踪。
(五)系统与运行时优化
- Windows 默认驱动模式由 TCC 切换为 MCDM,兼容更多消费级 RTX 显卡完整 CUDA 功能。
- Windows WDDM 模式单上下文本地共享内存(LMEM)占用降低,小内核启动内存开销缩减。
- 新增
cudaMemcpyWithAttributesAsync精细化异步内存拷贝 API,带宽利用率提升。 - ARM 生态完全统一:服务器 ARM、Jetson 嵌入式共用同一套 Toolkit 安装包,取消分离工具链NVIDIA。
- 废弃老旧架构:不再维护 Pascal (SM6.x),最低兼容起点提升至 Turing (SM7.5)。
四、系统要求(CUDA 13.3)
1. 硬件 GPU 要求(算力 Compute Capability)
- 最低算力:7.5(Turing 架构:RTX 20 系、T4)
- 完整优化支持:8.x (Ampere/Ada)、9.0 (Hopper)、10.0/12.0 (Blackwell)
- 显卡品类:GeForce RTX 消费卡、RTX A 专业绘图卡、H100/H200/A100 数据中心卡、Jetson Thor/Orin 嵌入式 GPU
- 显存建议:开发调试≥6GB;AI 训练≥24GB;大模型推理≥80GB
2. 操作系统平台
Windows(仅 64 位)
- 桌面系统:Win10 22H2、Win11 22H2/23H2/24H2/25H2
- 服务器系统:Windows Server 2022、Windows Server 2025
- 依赖 IDE:Visual Studio 2019、2022(MSVC 192x/193x)
Linux
- x86_64:Ubuntu 20.04/22.04、RHEL 8/9、Rocky Linux、SLES 15
- ARM64(SBSA 服务器、Jetson):Ubuntu 22.04 aarch64、RHEL ARM 版
- 编译依赖:GCC/G++ 11~13、glibc 2.31 及以上
其他兼容环境
- WSL2 Windows 子系统、Docker 容器、云主机 GPU 实例
3. NVIDIA 驱动版本硬性匹配
- Toolkit 13.3 最低驱动版本:Windows ≥555.xx;Linux ≥555.xx
- 兼容规则:驱动版本向上兼容,新驱动可运行所有旧版 CUDA 编译程序;旧驱动无法运行高版本 Toolkit 编译程序
4. 硬件主机配置
- CPU:x86_64 Intel/AMD;ARM64 Cortex-A/Neoverse;无低频限制,多核提升编译与调度速度
- 内存 RAM
- 最低:4GB
- 常规开发推荐:16GB+
- 多 GPU 大工程 / 分布式训练:64GB 及以上
- 磁盘空间
- Toolkit 安装占用:约 4.5GB
- 预留工作空间:至少 10GB(含示例、库文件、编译缓存)
- 额外依赖
- Windows:VC++ 运行库、管理员安装权限
- Linux:gcc、make、cmake、libgtk(图形 Nsight 工具)
- 嵌入式 Jetson:配套 JetPack 镜像环境
5. 开发语言环境限制
- NVCC 主机编译器:Windows MSVC、Linux GCC、ARM aarch64-gnu-gcc
- C++ 标准:默认 C++17,可选开启 C++20/C++23
- Python 配套版本:3.9~3.12 适配 CUDA Python 1.0
下载地址
声明:本站所有文章资源都来自互联网,仅供学习和测试所用,任何个人或组织不得用于商业用途。如若本站内容侵犯了原著者的合法权益,可通过邮件(331752841@qq.com)联系我们进行处理。