在日常工作与内容创作中,我们经常需要将音频或视频中的人声提取出来并转换为文字。无论是整理会议录音、制作视频字幕,还是提取歌曲歌词,一款高效、稳定且保护隐私的语音转文字工具都显得尤为重要。
Vovsoft Audio to Lyrics Converter 正是为此而生。它是一款专为 Windows 平台设计的轻量级 AI 语音转文字软件,体积约 133.4 MB,能够自动识别音频/视频文件中的人声,并精确转换为带时间戳的文本内容。
核心功能详解
1. 离线 AI 处理,保护隐私
该软件完全运行在本地电脑上,无需联网,也无需订阅任何云端 API。所有音频文件都不会上传至服务器,处理过程由本地硬件完成,确保商业机密和个人隐私安全。用户可以选择不同大小的离线 AI 模型(如轻量级 465 MB 模型),在转换速度与识别准确率之间自由平衡。
2. 广泛支持多种音视频格式
软件支持主流的音频格式,包括:
- MP3
- WAV
- OGG
- FLAC
同时也支持从视频文件中直接提取人声进行转录。
3. 多种输出格式,满足不同场景
根据使用需求,用户可将转录结果导出为:
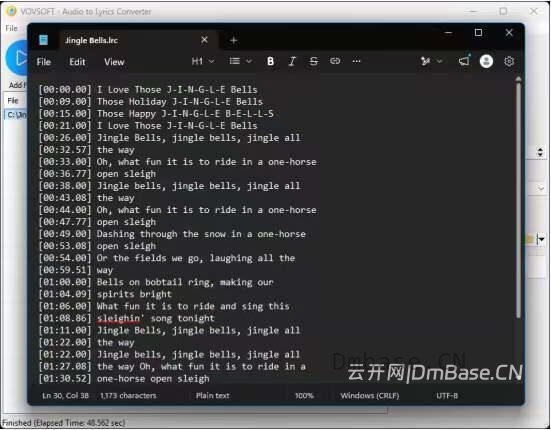
- LRC 文件:适用于音乐播放器、卡拉 OK 场景,实现歌词同步显示。
- SRT / VTT 文件:用于视频字幕制作,兼容主流视频编辑软件和播放器。
- TXT 文件:纯文本格式,方便阅读、整理或存档。
4. 自动生成精确时间戳
软件能够自动为每句文本生成精准的时间戳标签(格式如 [00:26.00]),确保歌词或字幕与音频节奏完美匹配,无需手动调整。
5. 批量转换与文件夹支持
用户可以一次性添加多个单曲,或直接拖放整个文件夹,实现批量处理。软件会依次完成所有文件的转换,大幅提升工作效率。
6. 可自定义文本行长度
生成的歌词或字幕行长度可根据需要进行调节,确保在不同屏幕尺寸或媒体播放器上都能获得良好的显示效果。
7. 拖放式操作,界面友好
支持直接拖放文件或文件夹到软件界面,无需复杂设置,上手即用。
8. 基于 OpenAI Whisper 本地模型
软件采用了先进的 OpenAI Whisper 模型,并在本地运行。该模型具备高精度的多语言识别能力,即使在不联网的环境下,也能保持出色的转录质量。
适合哪些行业或企业?
| 行业 / 场景 | 典型用途 |
|---|---|
| 视频制作与后期 | 为采访、Vlog、课程视频快速生成 SRT/VTT 字幕。 |
| 音乐与娱乐 | 为卡拉 OK 曲库制作 LRC 同步歌词文件。 |
| 企业与行政办公 | 转录会议录音、客户通话记录、项目讨论音频为 TXT 文档。 |
| 教育与培训 | 将讲座、网课、研讨会录音转为文字笔记或字幕。 |
| 播客与内容创作 | 将播客访谈、有声内容转为文字稿,便于发布或二次编辑。 |
| 新闻与采访 | 快速整理采访录音,提高稿件撰写效率。 |
系统要求
- 操作系统:Windows 11 或 Windows 10(64 位)
- 建议硬件:具备一定性能的 CPU(支持 AI 推理加速为佳)
下载地址
声明:本站所有文章资源都来自互联网,仅供学习和测试所用,任何个人或组织不得用于商业用途。如若本站内容侵犯了原著者的合法权益,可通过邮件(331752841@qq.com)联系我们进行处理。